同一批成都住宅问题,我上一篇看的是具体楼盘。这次把视线往上移一层,看看开发商品牌词在豆包回答里怎样出现。
我把 50 道购房问题各问了 5 次,拿到 250 条有效回答。这里的“出现”只表示回答正文包含这个词。它不能告诉我们购房者是否认识该品牌,更不能代替销量、市场份额或品牌好感度。
品牌词被提到多少次
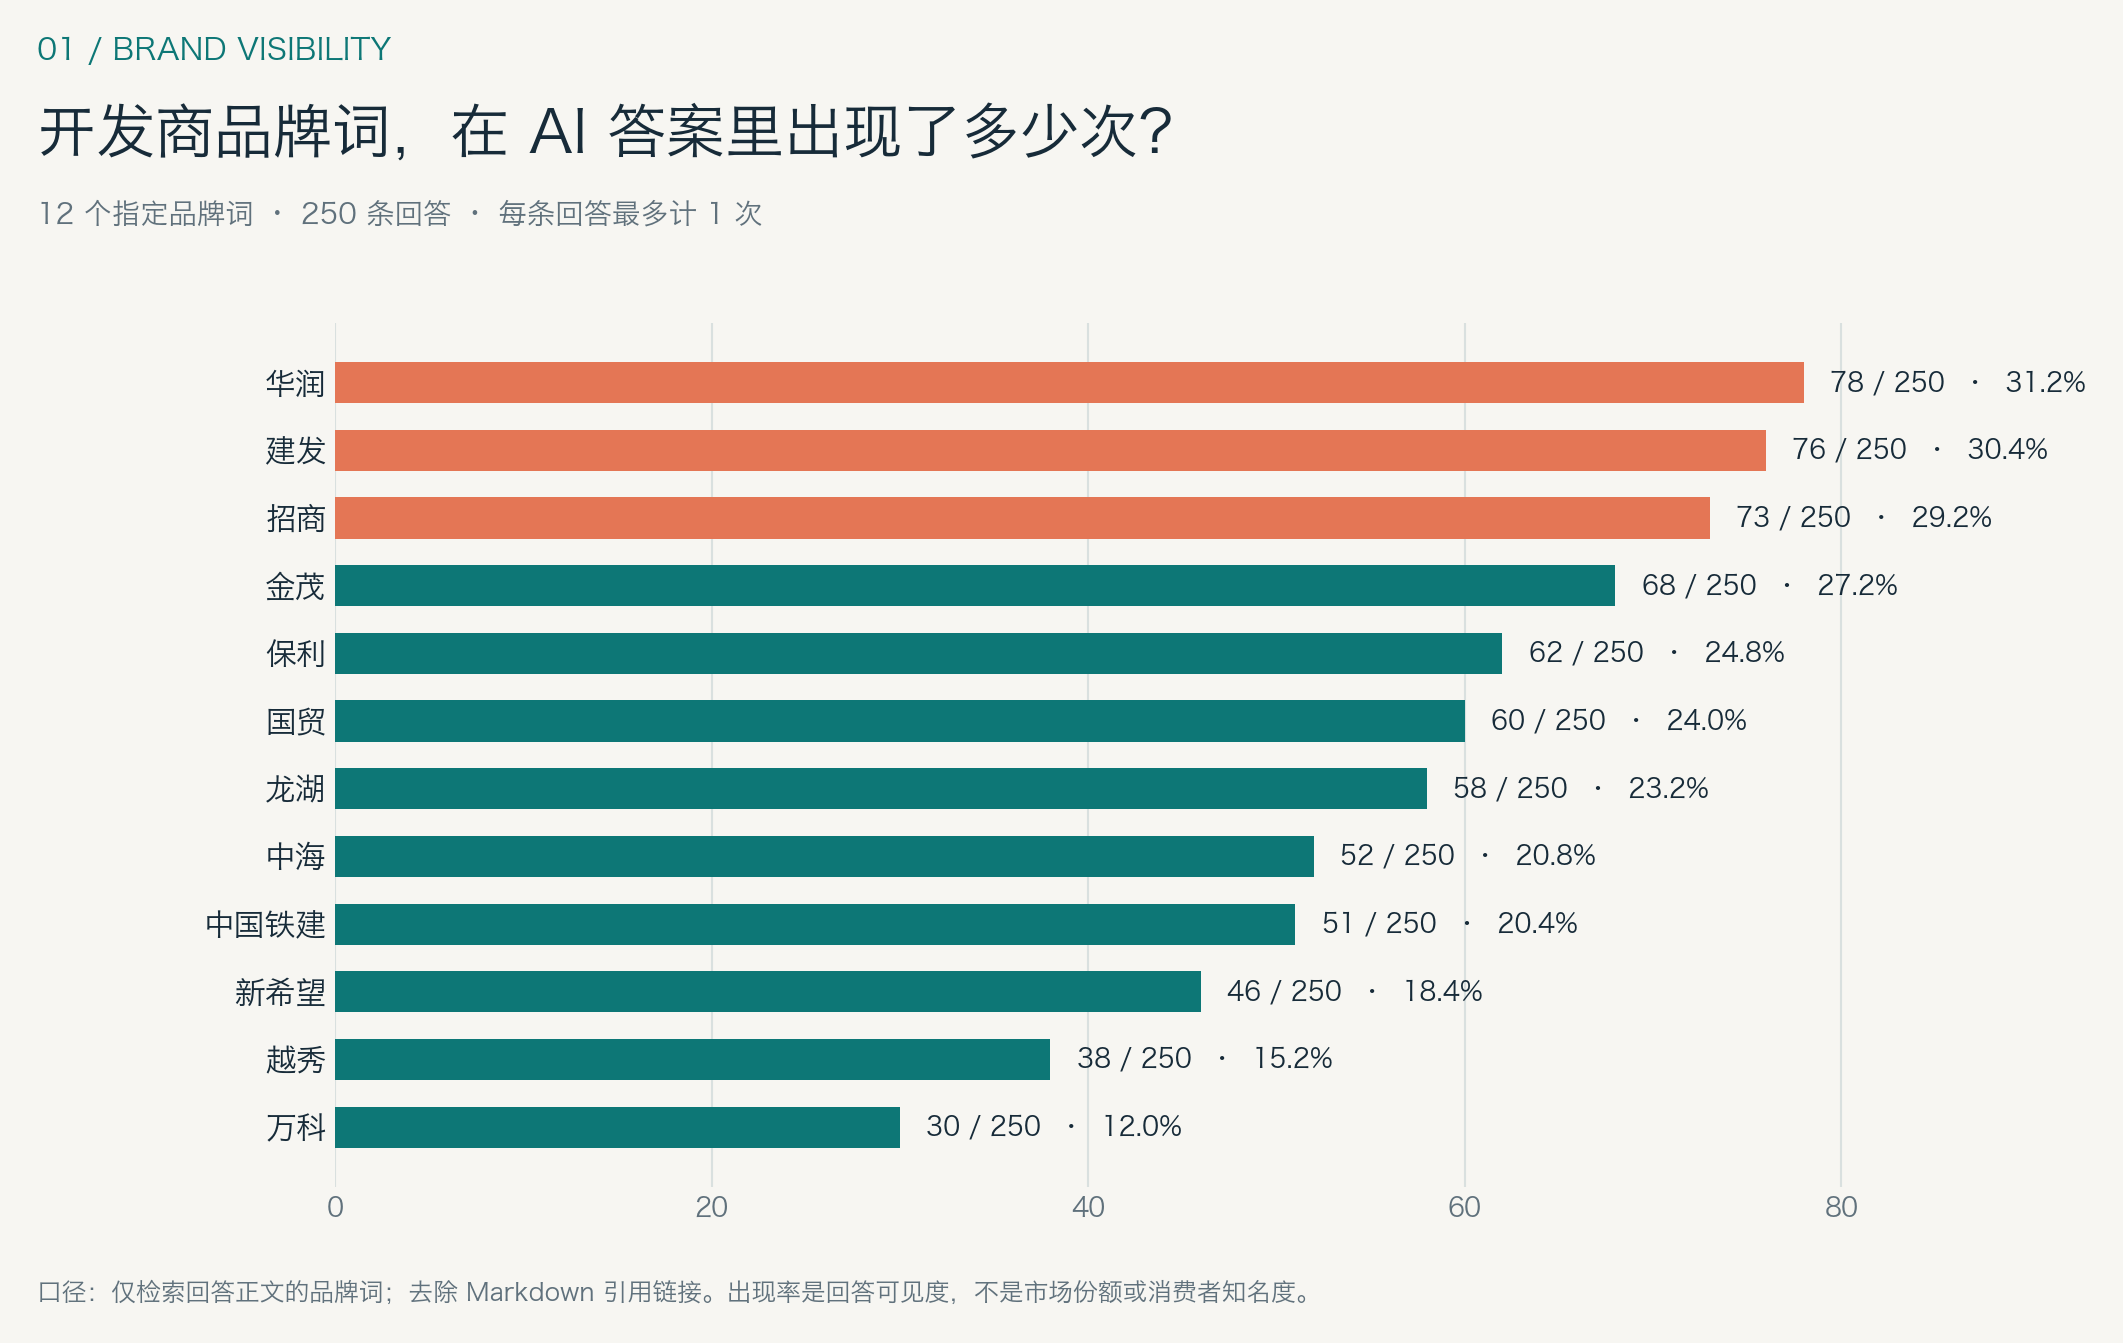
华润出现 78 次,建发 76 次,招商 73 次,保利 62 次。数字看起来很接近,但先别急着把它排成“开发商品牌认知榜”。我匹配的是词,不是完整的公司主体。项目名里带有品牌词,也可能被算进去;我没有逐条核对这些项目的开发主体。
这张图对我有用的地方,是把一个很模糊的问题变具体了。假如品牌词在这批回答里很少出现,可以继续追问,是所有购房问题都缺席,还是只在某几类需求中缺席。
项目名和品牌词要分开看
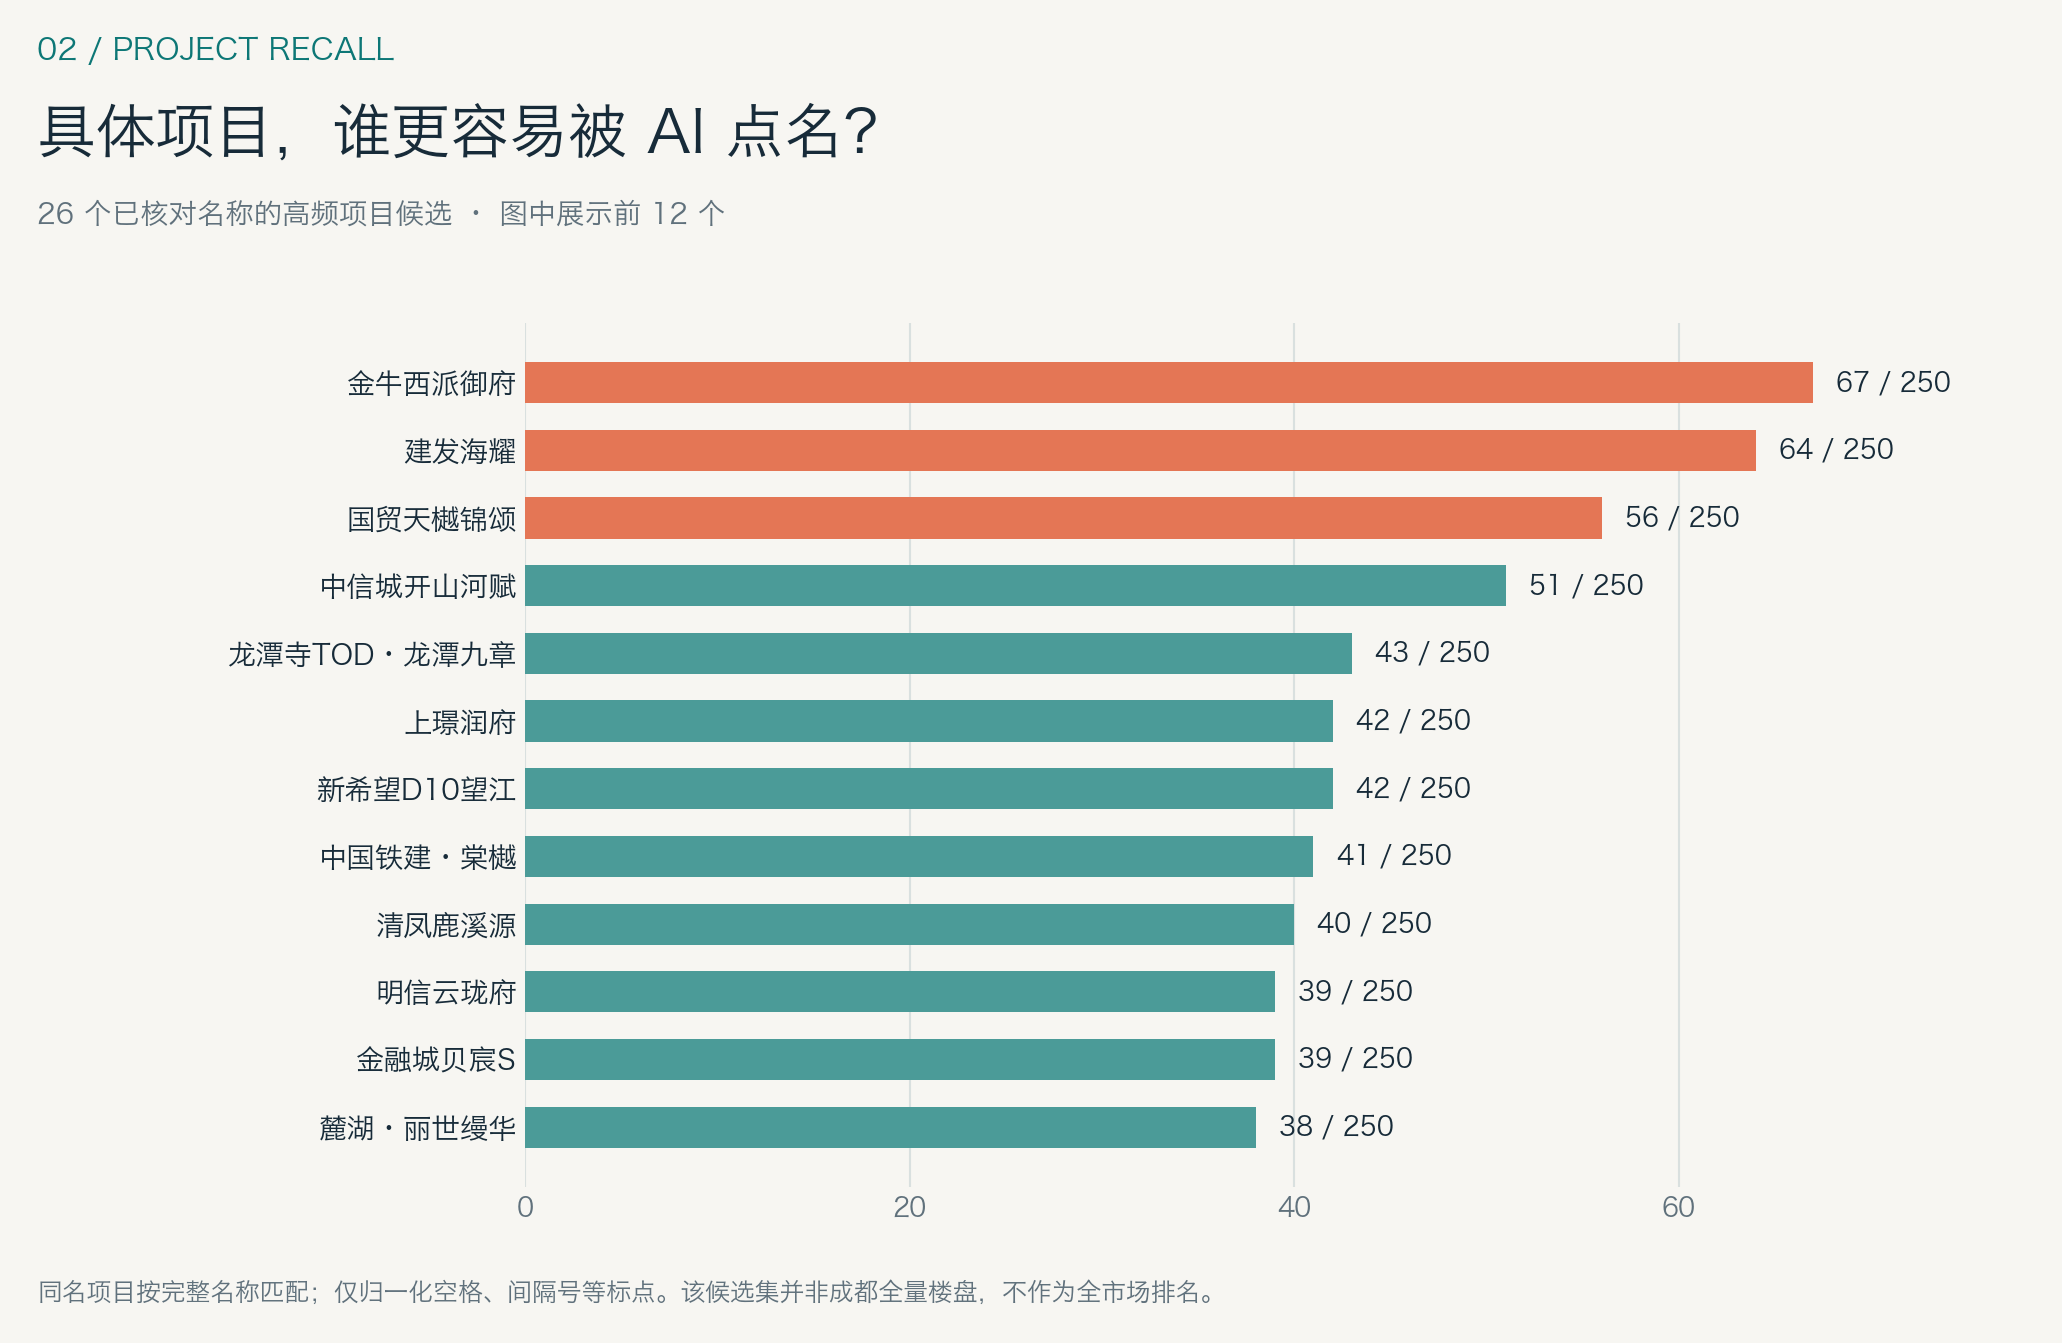
在固定观察的 26 个项目名称里,金牛西派御府出现 67 次,建发海耀 64 次,国贸天樾锦颂 56 次。一个具体项目被点名,与开发商品牌本身被正确识别,是两件需要分别核对的事。品牌词可能来自项目名,回答也可能把项目的区位、产品或主体说错。
因此我不会仅凭图 1 和图 2 推断某家开发商的真实品牌优势。它们更像两张索引,告诉我该回到哪些原始回答,检查 AI 究竟在谈品牌,还是只复述了一个楼盘名称。
换一个购房需求,品牌词的分布就变了
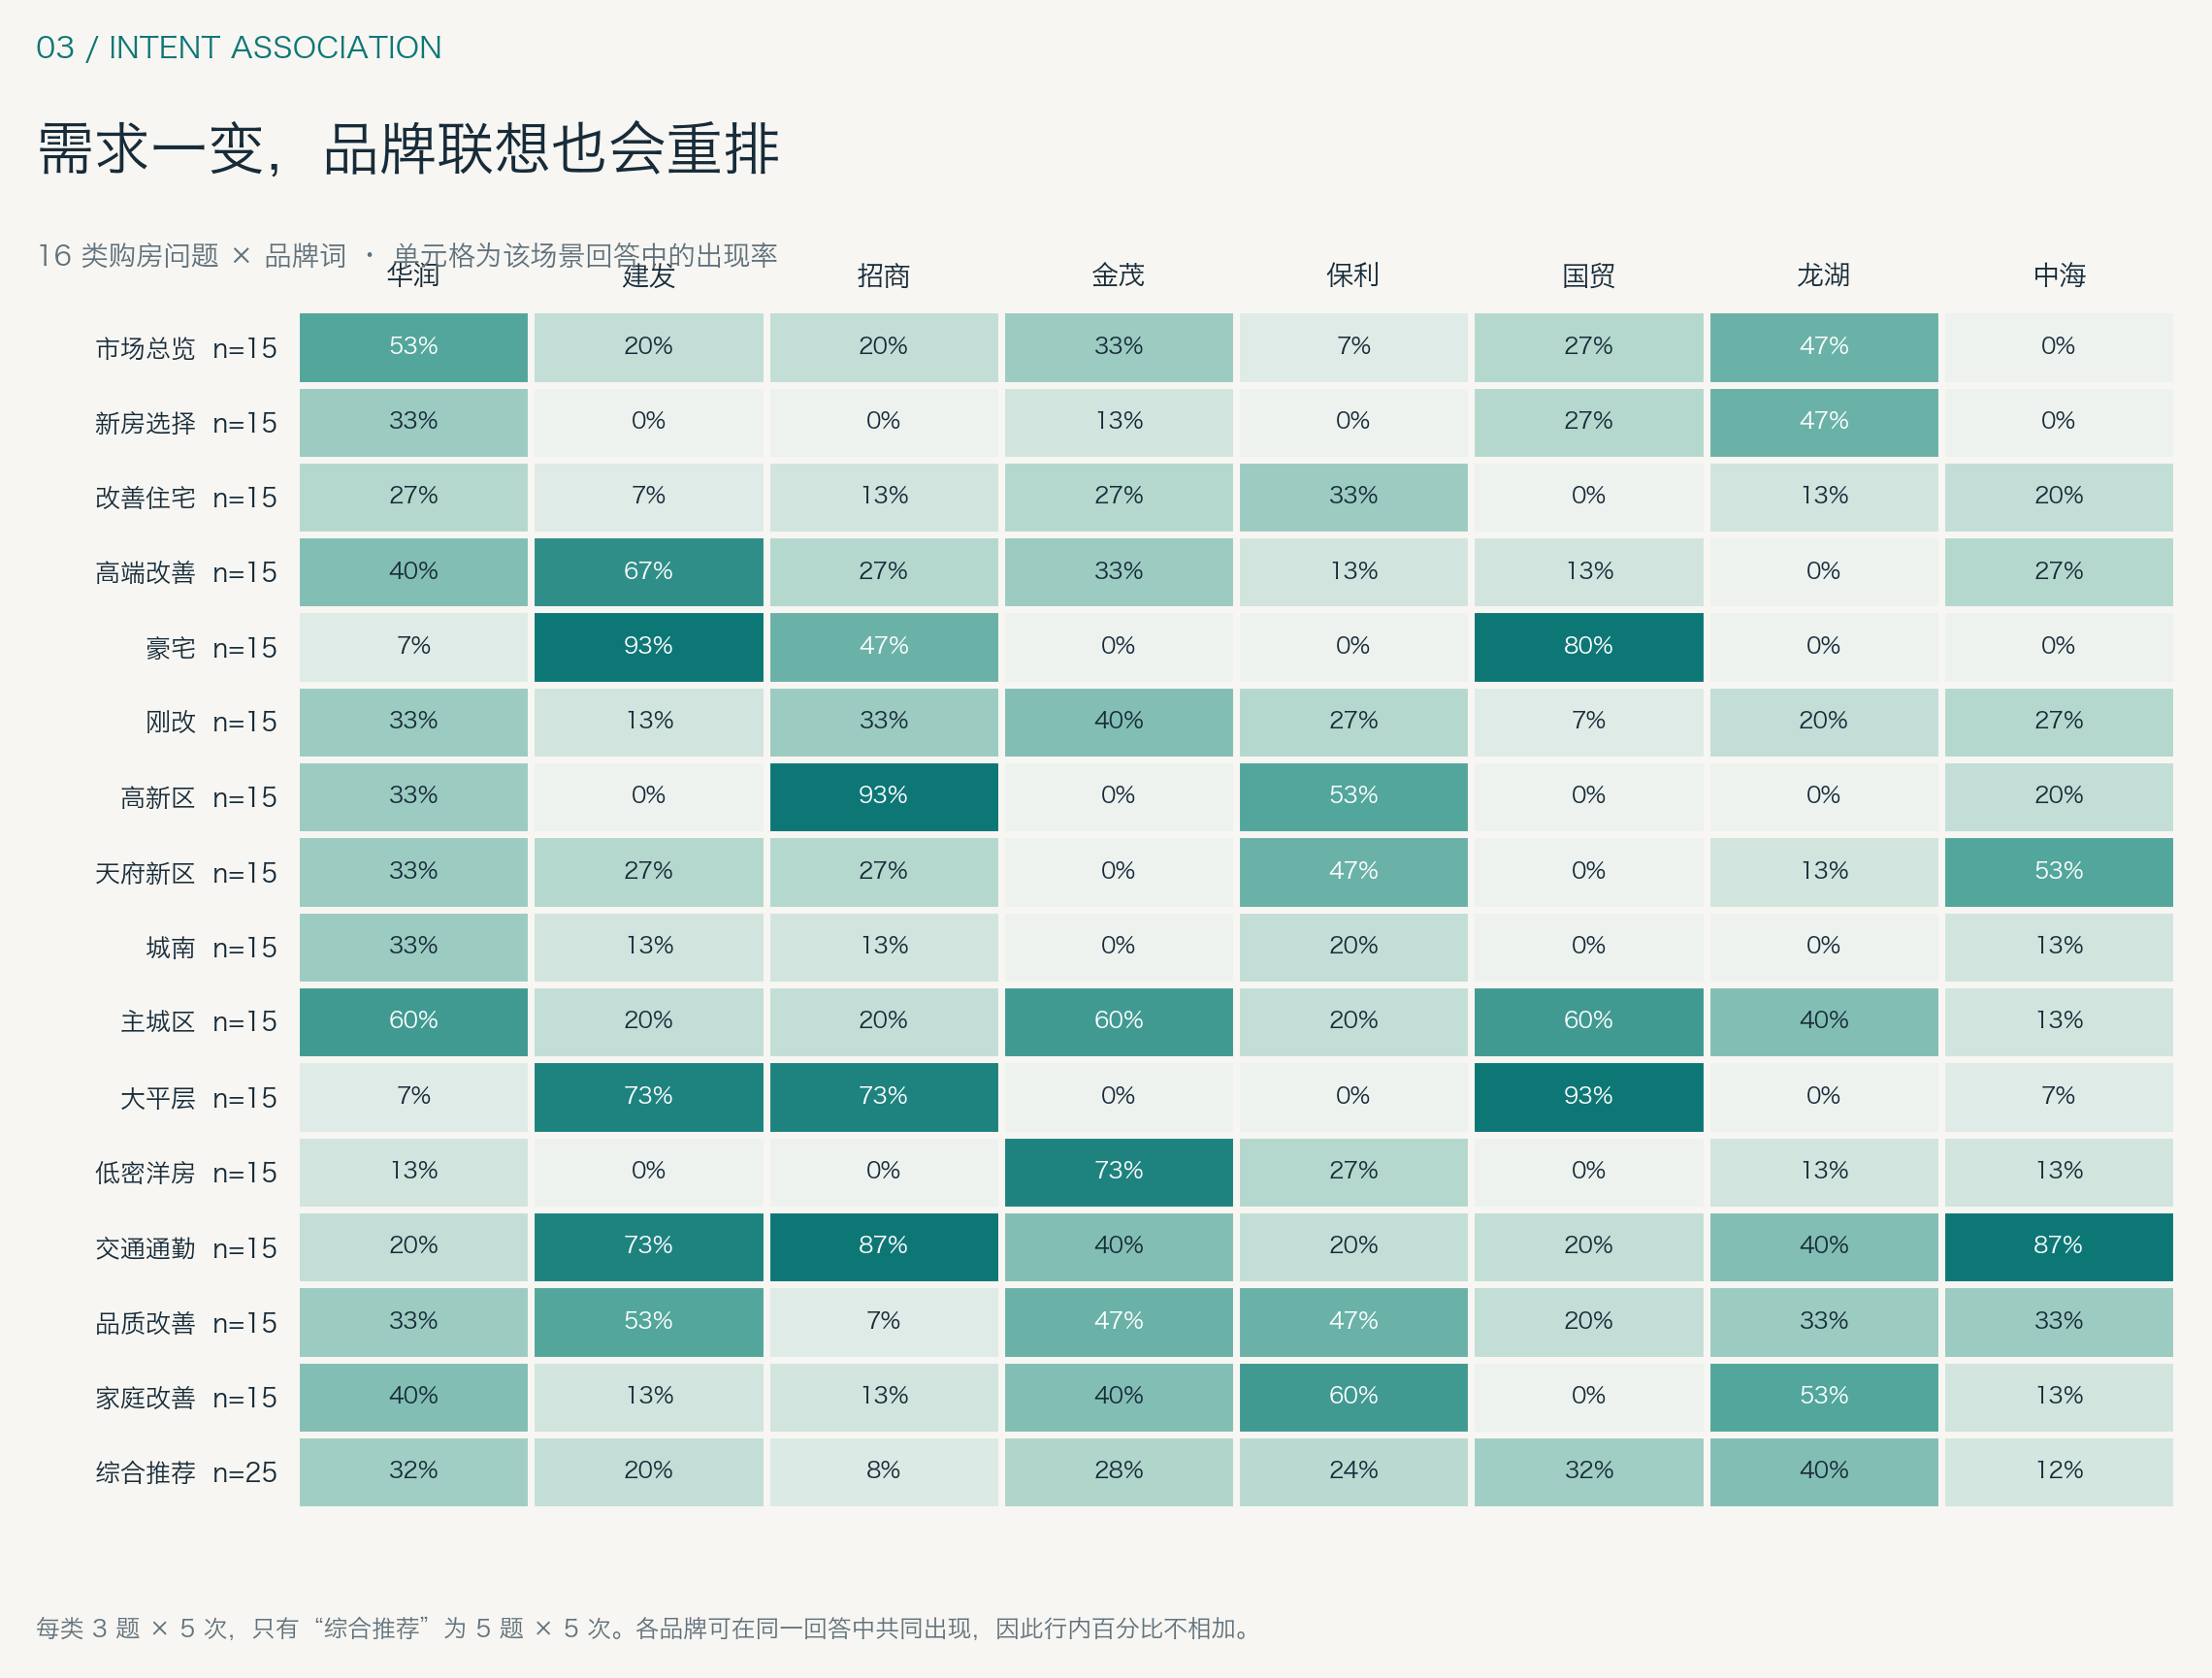
场景图比总次数更值得细看。豪宅类的 15 条回答里,建发出现 14 次,国贸出现 12 次。高新区类的 15 条回答里,招商出现 14 次。家庭改善类的 15 条回答里,保利出现 9 次。它们并不说明这些品牌在真实购房者心中占据同样位置,只说明这批问题让模型更容易写出不同的品牌词。
如果一家开发商想知道自己在 AI 答案里的位置,先选真实业务相关的问题,再看对应回答。把“豪宅”“通勤”“家庭改善”混成一个总数,可能正好抹掉最重要的差别。
同一道题问五次,答案也未必站得住
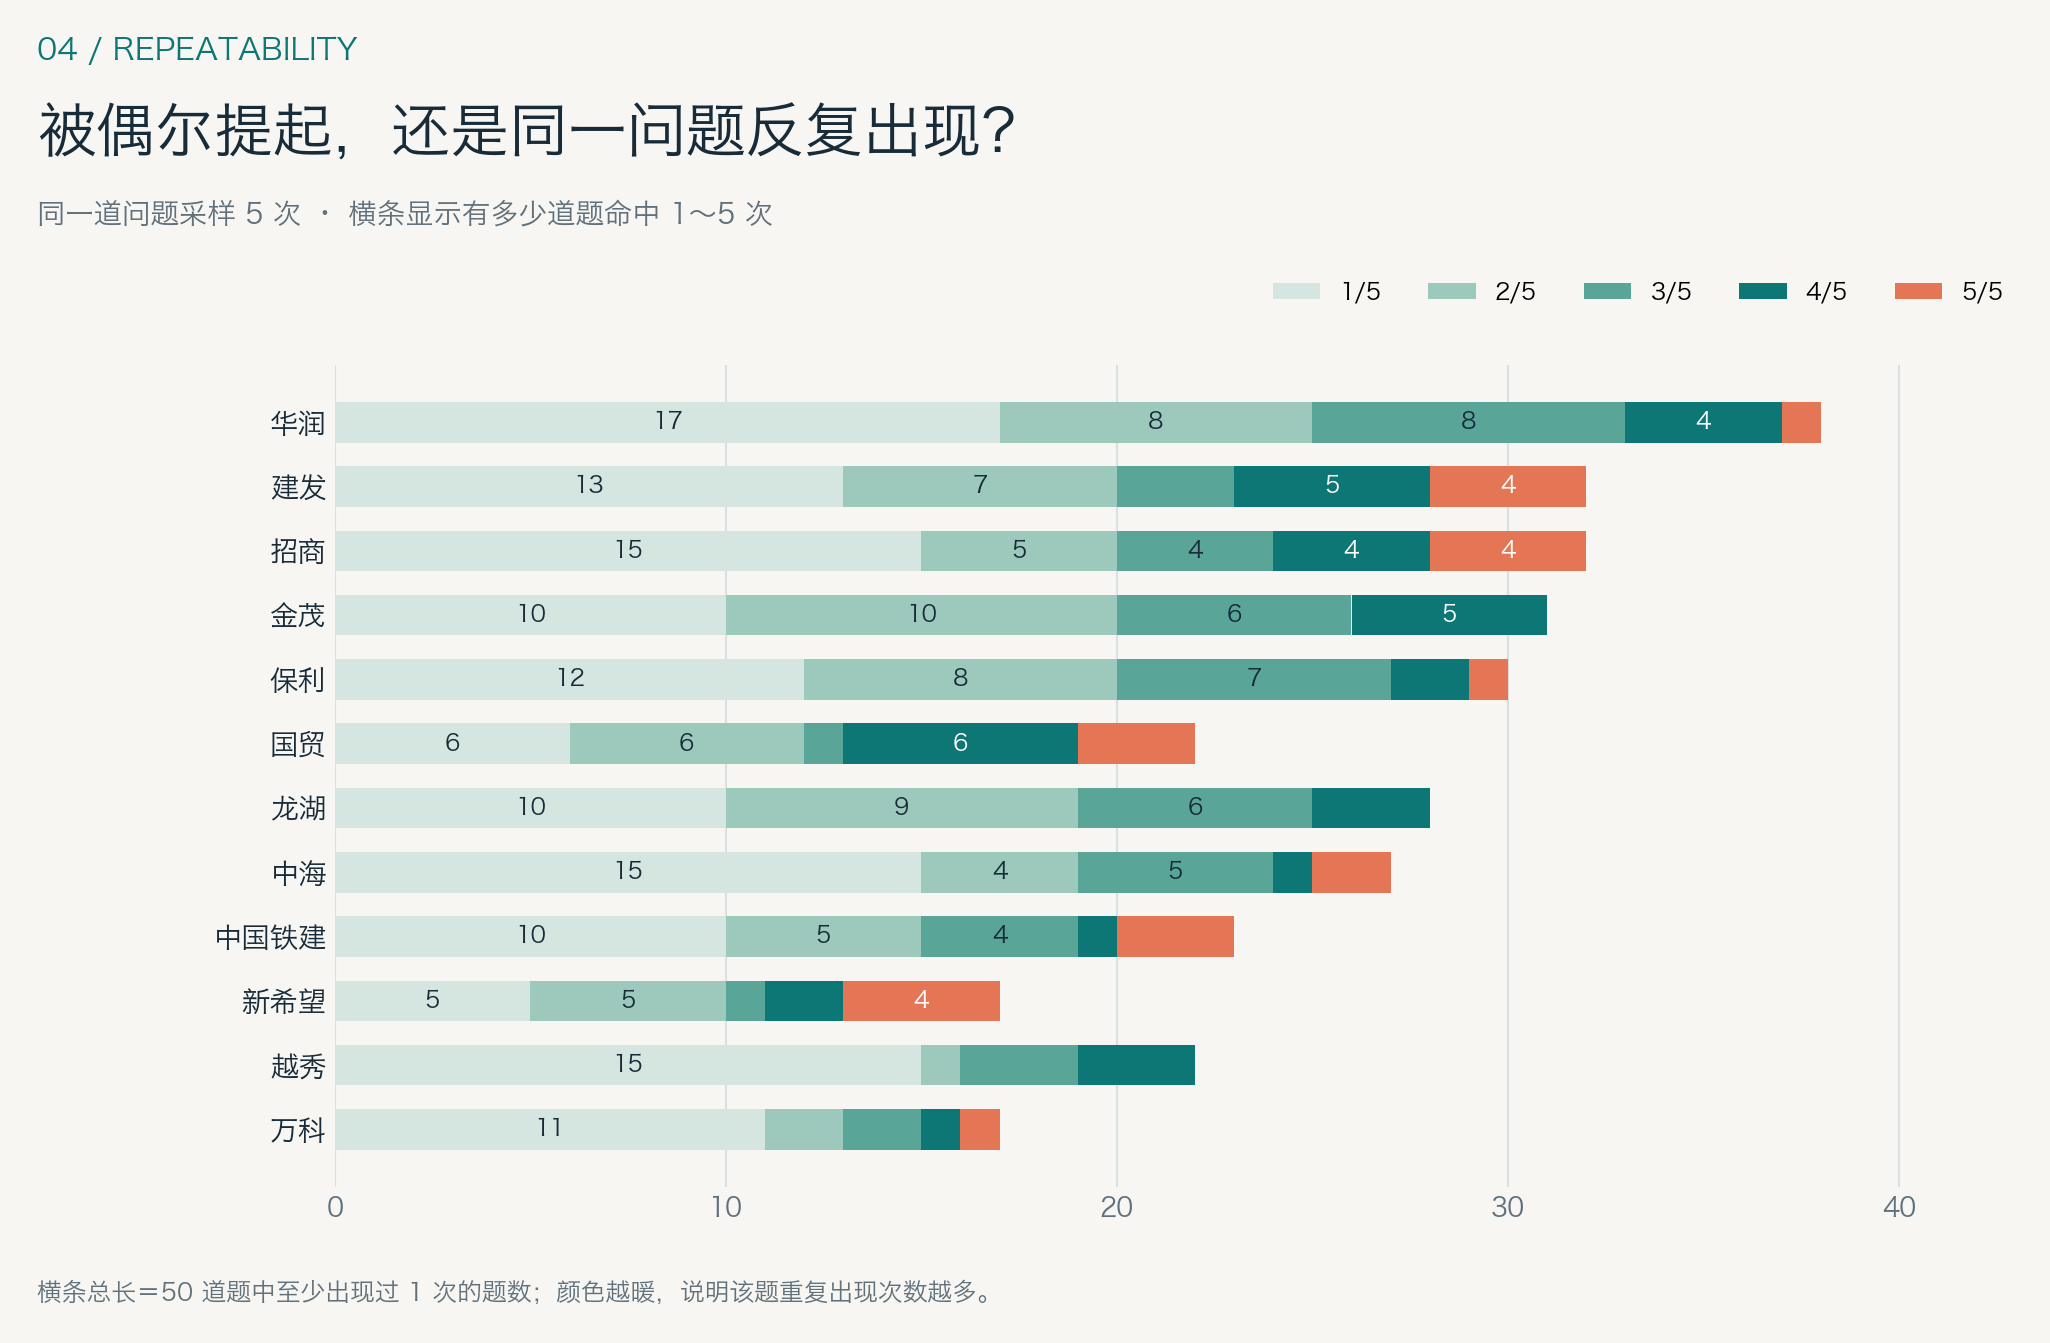
建发在 4 道题里达到了 5 次提问、5 次都出现;华润虽然总出现次数略高,达到 5 次全中的题却只有 1 道。再看保利,它覆盖了 30 道题,其中 12 道只在五次重复里出现过一次。单看 62 次的总数,很难看到这层差异。
我更愿意把这样的图当作下一轮复核的线索。先找出与项目定位有关、但品牌词只偶尔出现的题,再读原始答案,看看模型有没有说对项目事实,有没有把品牌和项目连起来。次数之外,还要核对它说了什么。
这批数据能回答到哪里
采样发生在 2026 年 9 月 29 日,只使用豆包经火山方舟提供的 doubao-seed-2-0-lite-260215 模型。50 道题每题独立采样 5 次,Temperature 为 0;250 条记录均标记为有效。图表只对回答正文做固定词匹配,并排除了 Markdown 引用链接的标题与网址。
采样时请求启用网页搜索,但传输记录没有观察到搜索调用。因此我只把它当作这批 AI 回答的快照,不把图里的项目描述当成已核验的在售、价格、区位或开发主体事实。12 个品牌词和 26 个项目名称都是预先选定的观察集合,不能外推到成都所有品牌和楼盘。
如果要用它做品牌诊断,下一步应该固定自己的真实问题集,再把“出现了品牌词”“认对了品牌与项目”“给出了可靠推荐理由”分开复核。这比把一次回答截图做成排名,更接近我想知道的事。
研究证据与完整性校验
本次私有证据包留存了原始采样、统计摘要、制图脚本和四张图。文末的 SHA-256 用来核对这组文件以后是否被改动,不证明结论必然正确,也不证明发生了联网搜索。
Evidence ID DOUBAO-CHENGDU-BRAND-MENTIONS-20260929-V1
Root SHA-256 f1354c171b3a50d0242b985d3b27f6632eb47558bb0846bcc282d56936d6ccf2